在企业数字化转型深度落地、数据量级爆发式增长、业务场景极速迭代的当下,数据架构的选型成为决定企业数据治理效率、数据分析能力与业务创新速度的核心关键。传统集中式数据仓库架构凭借标准化、高一致性的优势,数十年间支撑了企业BI报表、经营分析、数据决策等核心场景,是企业数据体系的基石架构。
而Data Mesh(数据网格)作为新一代分布式数据架构范式,打破了集中式数据管理的固有模式,以领域驱动、数据产品化、联邦治理为核心,重构了企业数据的生产、治理、流通与应用逻辑,成为大型互联网、金融、制造企业数字化升级的核心方向。二者并非简单的技术迭代替代关系,而是集中式集权治理与分布式分权自治的架构理念博弈。本文将从架构本质、核心特性、优劣差异、适用场景、落地痛点及融合趋势六大维度,全面拆解两大架构的核心差异与落地价值,为企业数据架构选型提供专业参考。
一、两大架构核心本质与底层逻辑
想要精准辨析两大架构的优劣,首先需要厘清二者的底层设计理念与核心运行逻辑,这是所有差异的根源。
1.传统数仓架构:集中式统一治理范式
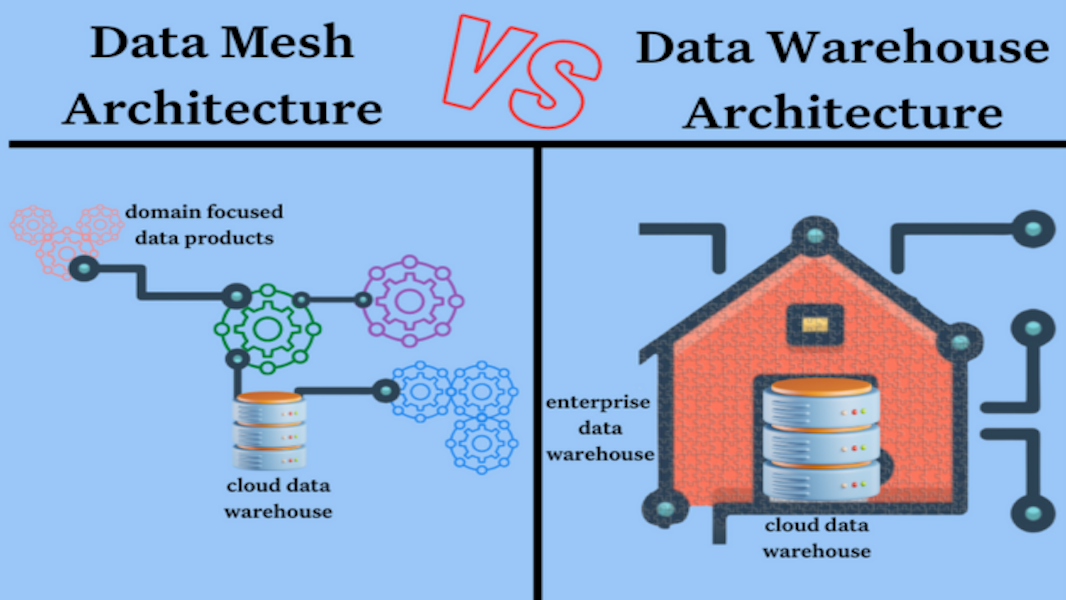
传统数据仓库(DW)是典型的中心化、一体化、自上而下的数据架构,核心设计理念是“数据统一汇聚、统一治理、统一服务”。其核心运行模式为:企业各业务系统(ERP、CRM、OA、交易系统等)的原始数据,通过ETL工具统一抽取、清洗、转换后,集中汇聚到单一的数仓存储集群,由专属中央数据团队负责数据建模、分层存储、质量管控、权限管理与接口输出。
整个架构以“全局统一”为核心目标,构建标准化的数据分层体系(ODS、DWD、DWS、ADS),形成企业唯一的数据真值来源,所有业务分析、报表展示、数据查询需求均由中央数仓统一响应。本质上,传统数仓不仅是一套存储技术架构,更是一套中央集权式的数据管理体系,将数据所有权、治理权、使用权全部收拢至专业数据团队手中。
2.Data Mesh架构:分布式领域自治范式
Data Mesh并非全新的存储技术,而是一套组织架构+数据治理+技术规范的综合性分布式数据管理范式,核心源于领域驱动设计(DDD),彻底颠覆了传统集中式数据管控模式。其核心逻辑是“数据归领域、责任归团队、产品化输出、联邦式治理”。
Data Mesh将企业整体数据体系按业务领域拆分(用户、订单、商品、供应链、财务等),每个业务领域团队独立负责自身领域数据的采集、加工、治理、存储与服务输出,将数据封装为标准化、可复用、可溯源的数据产品。企业不再设置统一的中央数据管控团队,仅通过全局统一的技术规范、治理规则与元数据体系,实现跨领域数据的互联互通,形成“分布式生产、标准化流通、全局可治理”的数据生态。
相较于传统数仓的技术架构升级,Data Mesh更大的变革在于数据权责的重构,实现了数据从“公共资源”向“领域资产”的转变。
二、Data Mesh与传统数仓核心维度优劣对比
基于底层逻辑的差异,两大架构在数据所有权、扩展性、治理模式、响应效率、落地成本、数据一致性等核心维度呈现出截然不同的特性,以下结合企业实际落地场景进行全方位优劣拆解。
1.数据所有权与权责体系
传统数仓:采用中央集权式权责。数据所有权、治理权、运维权全部归属企业中央数据团队,业务团队仅为数据使用者,无需参与数据治理工作。这种模式的优势是权责清晰、统一管控,避免业务侧数据治理混乱;劣势是形成严重的数据供需瓶颈,所有数据需求、指标变更、报表迭代都依赖中央团队,业务侧无数据自主能力,需求响应链路长、效率低。
Data Mesh:采用领域自治式权责。谁生产数据、谁治理数据、谁负责数据质量,领域团队作为数据产品的所有者,全权负责本领域数据的全生命周期管理。优势是权责下沉、责任到人,数据生产与业务场景深度绑定,数据质量问题可快速溯源整改;劣势是权责分散,对各领域团队的数据能力要求极高,易出现各领域治理标准不统一的问题。
2.架构扩展性与业务适配性
传统数仓:垂直扩展为主,横向扩展受限。在企业业务稳定、数据量级适中的阶段,集中式架构的建模规范、分层体系可快速支撑标准化业务需求。但随着企业业务多元化、数据量级PB级增长、实时场景增多,集中式架构会暴露明显短板:核心集群算力、存储资源易达到瓶颈,扩容成本高;统一建模流程僵化,新增业务场景、自定义指标需要层层审批、重构模型,无法适配业务快速迭代需求,整体架构灵活性极差。
Data Mesh:天然支持横向无限扩展。各领域数据架构独立部署、独立迭代,新增业务领域无需改动原有整体架构,仅需快速搭建对应领域的数据产品体系即可。同时,领域团队可根据自身业务特性,灵活选择存储引擎、加工规则、更新频率,适配实时分析、离线统计、机器学习等差异化场景,完美适配互联网、新零售等业务高速迭代的企业需求。但其劣势在于,多领域分布式架构会提升整体架构复杂度,跨领域数据联动需要额外的标准化适配。
3.数据治理与一致性保障
传统数仓:强统一治理,数据一致性极高。依托统一的数据模型、统一的指标口径、统一的清洗规则,传统数仓可实现企业级“唯一数据真值”,彻底解决数据冗余、口径混乱、数据冲突问题,数据可信度、稳定性极强,极其适配财务核算、合规审计、经营复盘等对数据准确性、一致性要求极高的场景。但治理模式僵化,规则更新滞后,难以适配创新业务的个性化数据治理需求。
Data Mesh:联邦式治理,一致性可控但复杂度高。摒弃了一刀切的集中治理模式,采用“全局规则统一、领域细则自治”的联邦治理体系,通过代码化政策、元数据统一注册、数据产品标准化规范实现全局管控,同时保留领域治理灵活性。优势是治理弹性强、适配性广;劣势是天然存在数据碎片化风险,跨领域数据标准、口径、更新频率难以完全统一,若全局管控机制不完善,极易出现数据冗余、数据冲突,数据一致性整体弱于传统数仓。
4.需求响应效率与落地周期
传统数仓:标准化需求高效,个性化需求滞后。对于企业常规的固定报表、月度季度经营分析、标准化指标统计,传统数仓可依托成熟的数据模型快速输出结果。但面对业务临时分析、精细化场景迭代、创新业务数据需求,需要经过需求提报、模型调整、ETL重构、测试上线等漫长流程,周期长达数天甚至数周,无法支撑业务快速试错、实时决策。
Data Mesh:个性化、迭代性需求响应极速。领域团队深耕业务场景,对业务需求理解更精准,可自主完成数据模型调整、数据产品迭代,无需依赖中央团队,需求落地周期大幅缩短。同时,数据产品可复用、可自助查询,业务人员可自主获取数据,彻底解决传统架构的“数据排队、需求积压”问题。但对于企业级全局统一报表、跨领域综合分析,需要整合多领域数据产品,对接流程相对繁琐。
5.落地成本与运维难度
传统数仓:落地简单、运维集中、成本可控。架构成熟稳定、技术栈统一、人才体系完善,企业只需搭建一支小规模专业数据团队,即可完成全链路运维管理,初期建设成本、运维成本较低,落地风险极小。但随着数据量和业务量增长,后期集群扩容、模型重构、人力成本会持续攀升,长期边际成本递增。
Data Mesh:落地门槛高、初期成本高、运维分散。Data Mesh的落地不仅是技术改造,更是组织架构、人员能力、流程规范的全方位升级。企业需要为每个领域配备专属数据人才,搭建统一的元数据平台、数据目录、权限体系、监控体系,初期技术投入、人力投入、培训成本极高。同时,分布式架构运维节点多、链路复杂,运维难度远高于传统数仓,中小型企业落地极易出现“架构臃肿、治理混乱”的问题。
三、两大架构核心适用场景精准匹配
通过优劣对比可明确,Data Mesh与传统数仓不存在绝对的优劣之分,仅存在场景适配差异。企业架构选型的核心,是结合自身业务规模、组织架构、数据成熟度匹配最优方案。
1.传统数仓最优适用场景
一是中小型企业、业务模式稳定的传统行业企业(制造、化工、传统零售、政务等)。此类企业业务场景单一、数据量级较小、需求以标准化报表和常规经营分析为主,无需复杂的分布式架构,传统数仓低成本、高稳定、易运维的优势可最大化发挥。
二是对数据一致性、合规性、准确性要求极高的核心场景,包括财务核算、税务申报、合规审计、绩效考核、企业年度经营复盘等。这类场景要求数据绝对统一、口径唯一、可溯源、可审计,传统数仓的集中治理模式是最优保障。
三是数据体系处于初级建设阶段的企业。此类企业数据治理规范尚未完善,人员数据能力不足,集中式架构可快速搭建标准化数据体系,规避治理混乱风险。
2.Data Mesh最优适用场景
一是大型中大型互联网、金融、新零售企业。这类企业业务领域多、场景迭代快、数据量级庞大,集中式数仓的算力瓶颈、需求瓶颈、迭代瓶颈突出,Data Mesh的分布式扩展、领域自治能力可完美适配多元化、高速迭代的业务需求。
二是个性化分析、实时决策、数据创新场景密集的企业。包括用户精细化运营、实时风控、智能推荐、场景化营销、数据建模等,需要高频迭代、快速试错、自主取数,Data Mesh的自助式数据服务、快速迭代能力可大幅提升业务效率。
三是组织架构完善、领域团队数据能力成熟的大型集团企业。Data Mesh的落地依赖各领域团队的自主治理能力,成熟的组织架构和人才体系可规避分布式治理的混乱风险,充分发挥架构优势。
四、两大架构落地核心痛点
1.传统数仓架构核心痛点
第一,人力瓶颈严重,所有数据需求集中于中央团队,极易出现需求积压、响应滞后,成为业务迭代的核心卡点;第二,架构僵化滞后,统一模型难以适配个性化、创新化业务场景,模型重构成本高、周期长;第三,资源利用率低,集中式集群资源分配固化,部分场景资源过剩、部分场景资源不足;第四,业务与数据脱节,数据团队脱离一线业务,对业务场景理解不足,易出现数据模型与实际需求不匹配的问题。
2.Data Mesh架构核心痛点
第一,落地门槛极高,对企业组织能力、人才能力、技术基建要求严苛,中小型企业难以落地;第二,数据碎片化风险,领域自治易导致标准不统一、数据孤岛重生,跨领域数据协同难度大;第三,治理复杂度飙升,联邦式治理需要完善的全局规范和监控体系,一旦管控缺失,会彻底打乱企业数据体系;第四,初期投入成本高,人力、技术、运维成本远高于传统数仓,短期ROI较低。
五、行业主流趋势:架构融合而非单向替代
当前行业普遍存在认知误区:认为Data Mesh会彻底取代传统数仓。但从2026年企业落地实践来看,纯集中式数仓和纯分布式Data Mesh都并非最优解,二者融合架构成为主流趋势。
越来越多的大型企业采用“分布式生产+集中式汇总”的混合架构模式:底层依托Data Mesh架构,实现各业务领域数据的自治生产、快速迭代、自助服务,解决业务响应慢、扩展性差的问题;上层保留传统数仓的集中汇总能力,对各领域标准化数据产品进行统一汇聚、清洗、校准,生成企业级唯一真值,支撑财务、合规、经营分析等全局统一场景。
这种融合模式完美规避了两大架构的短板:既保留了Data Mesh的灵活性、扩展性、高效迭代能力,适配前端业务创新场景;又延续了传统数仓的高一致性、高规范性、高可信度,保障后端核心决策与合规场景的稳定运行。同时,依托数据目录、元数据管理、数据血缘等中间件能力,实现分布式数据与集中式数仓的无缝打通、双向联动,构建弹性、高效、稳定、合规的企业全域数据体系。
六、总结
传统数仓架构的核心价值是稳定、统一、合规、低成本,是企业数据体系的“压舱石”;Data Mesh架构的核心价值是灵活、高效、可扩展、高迭代,是企业数据创新的“助推器”。二者的本质差异是集中管控与分布式自治的理念差异,无绝对优劣,仅适配不同发展阶段、不同业务特性的企业。
针对企业架构选型,给出三点核心建议:第一,中小型企业、业务稳定的传统行业,优先深耕传统数仓架构,完善数据标准化治理,无需盲目跟风分布式架构;第二,大型集团、业务高速迭代的创新型企业,可分步落地Data Mesh架构,先实现核心领域数据自治,逐步搭建联邦治理体系;第三,中大型企业最优路径为混合架构落地,兼顾业务灵活性与数据统一性,实现数据效率与数据合规的双向平衡。